
回頭看這 28 天做的事,有一個結構相當清楚:
Day 11  記錄軌跡      → 原料
Day 13  評測與篩選    → 品管
Day 15  萃取與轉換    → 加工
Day 20  訓練          → 產出
Day 23  驗收          → 出貨檢驗
這就是一條產線。 只是每一站之間都是我手動搬過去的 —— 跑完評測、看報表、手動挑軌跡、手動轉檔、手動開 Colab。
今天要談的是:把這些手工搬運的環節接起來,讓它自己跑。
不過在開始之前,必須先講一句相當重要的話:
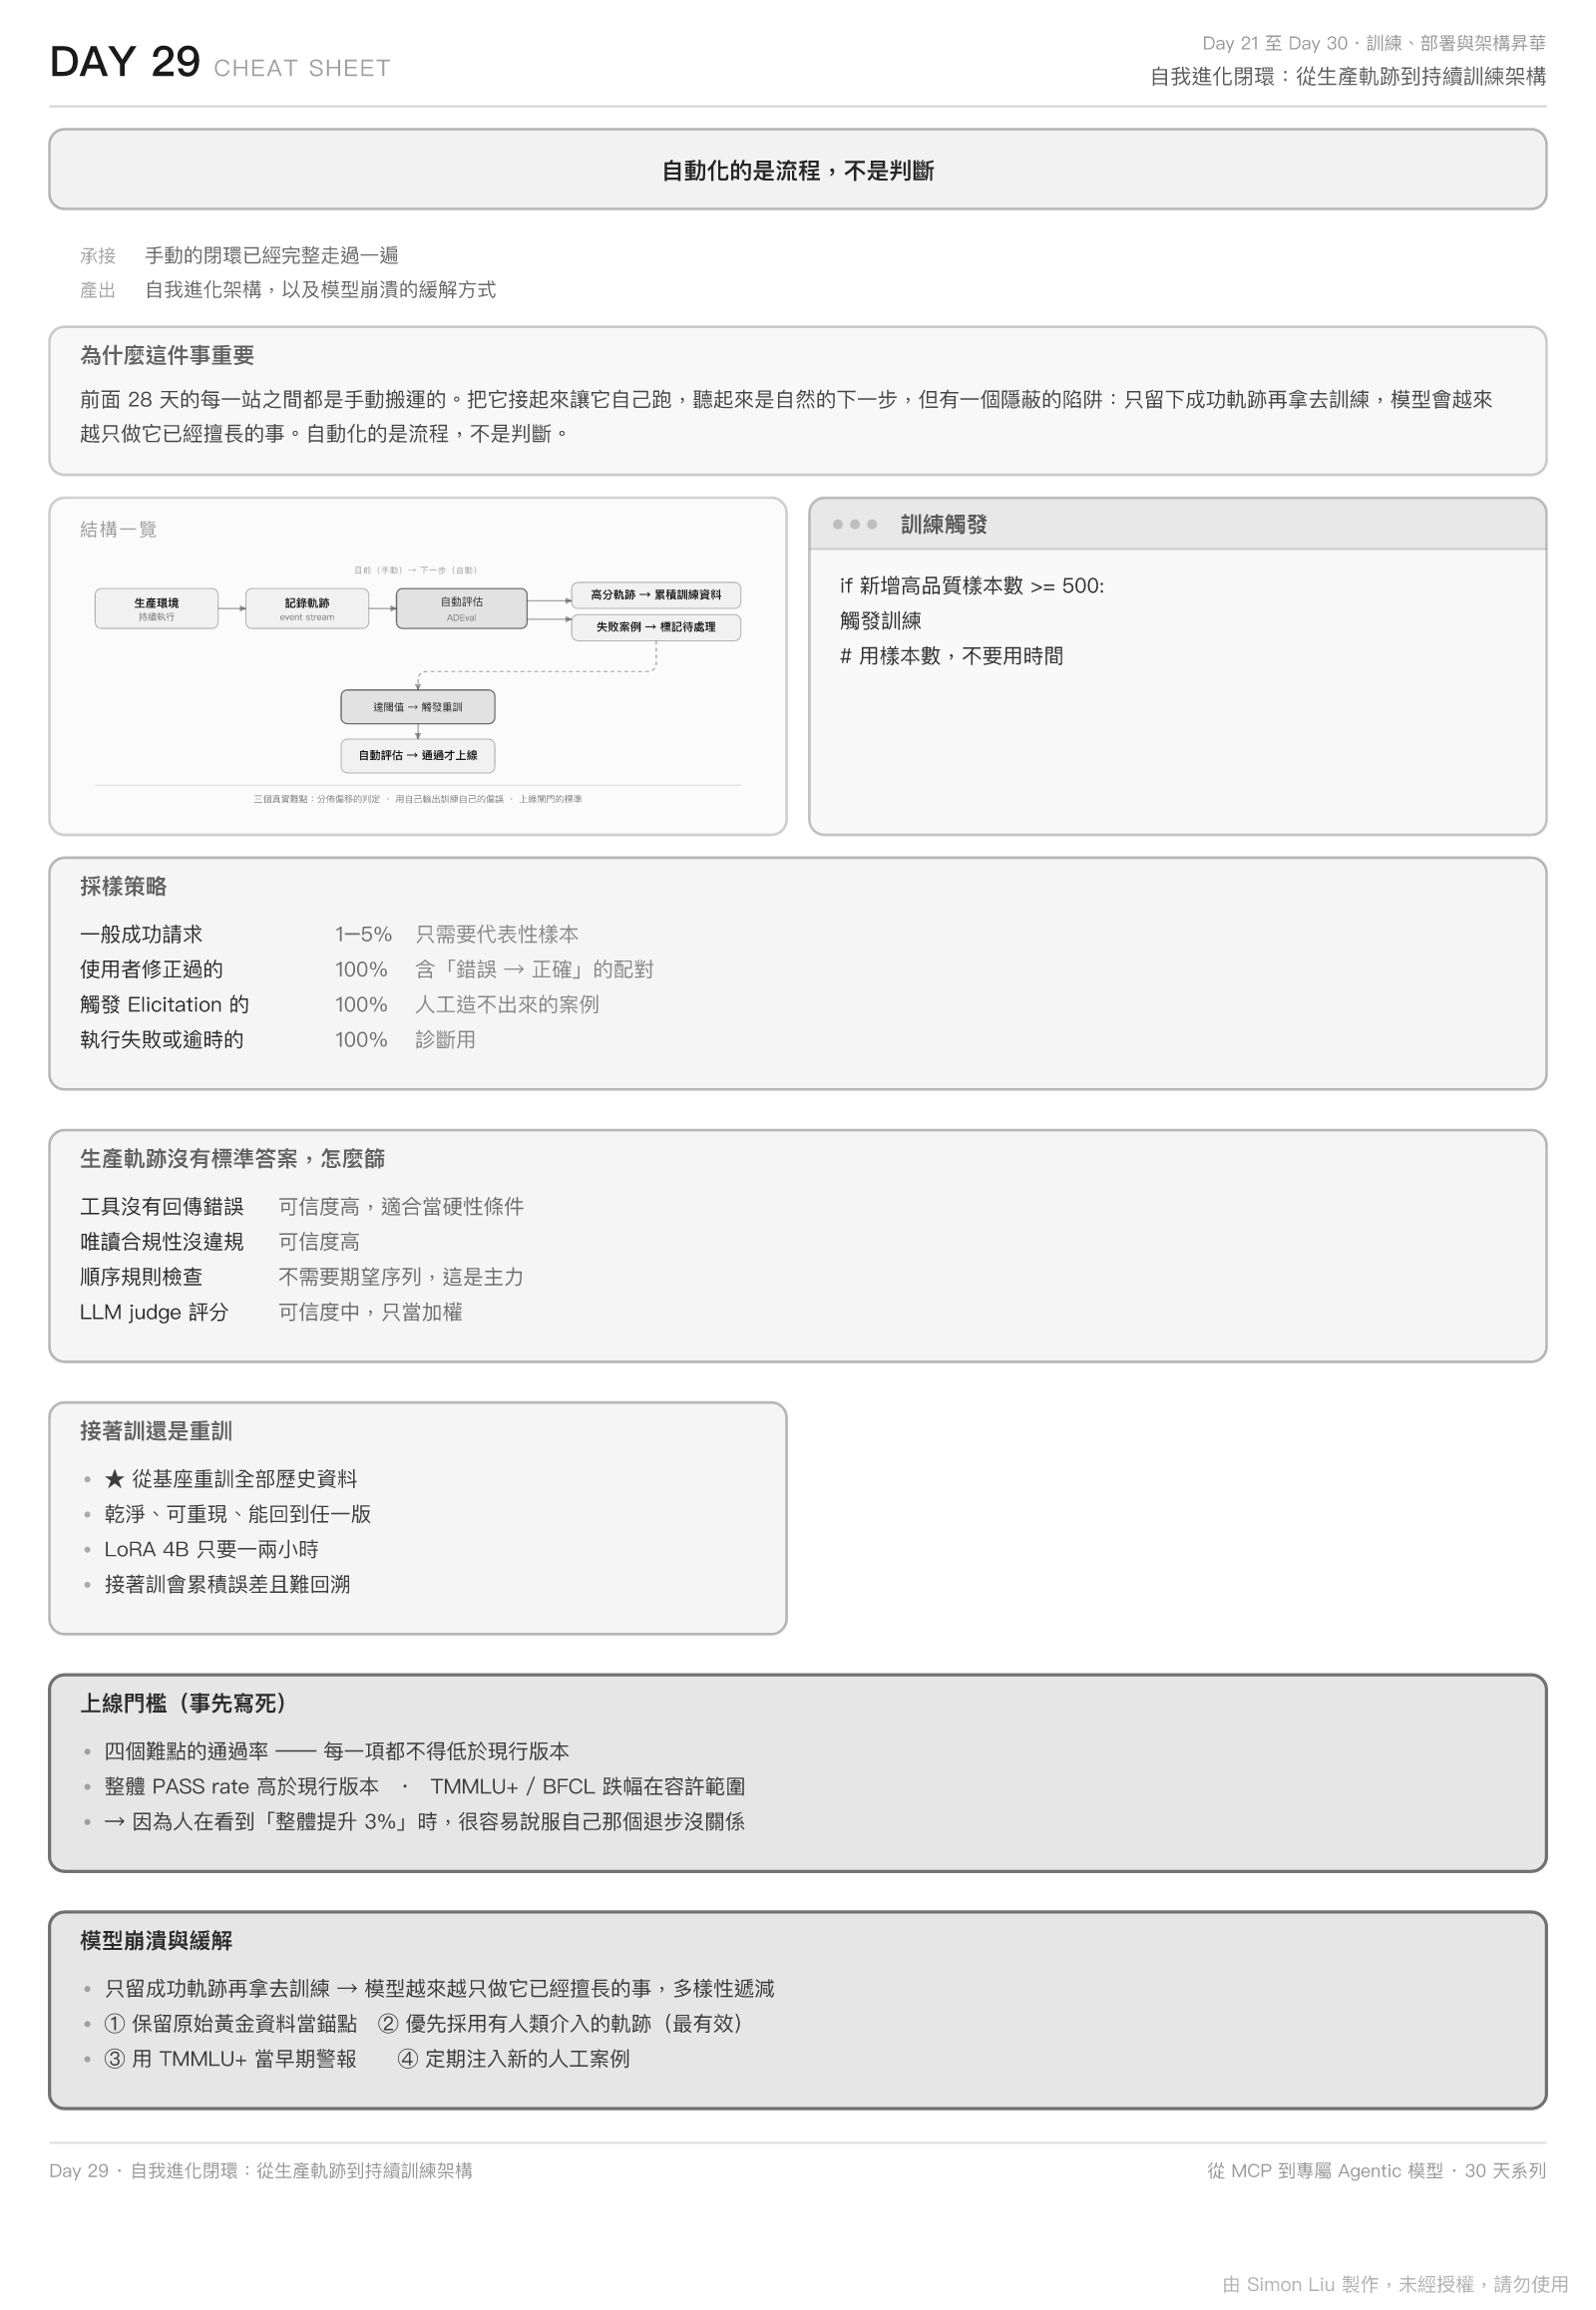
自動化的是「流程」,不是「判斷」。 這條產線上有幾個位置必須留人,而那幾個位置正是最容易被自動化的誘惑吃掉的地方。
以下的內容,會先拆解四個自動化階段的實作方式,接著說明必須保留人工的三個位置,最後處理這條路上最危險的一個陷阱 —— 模型崩潰。
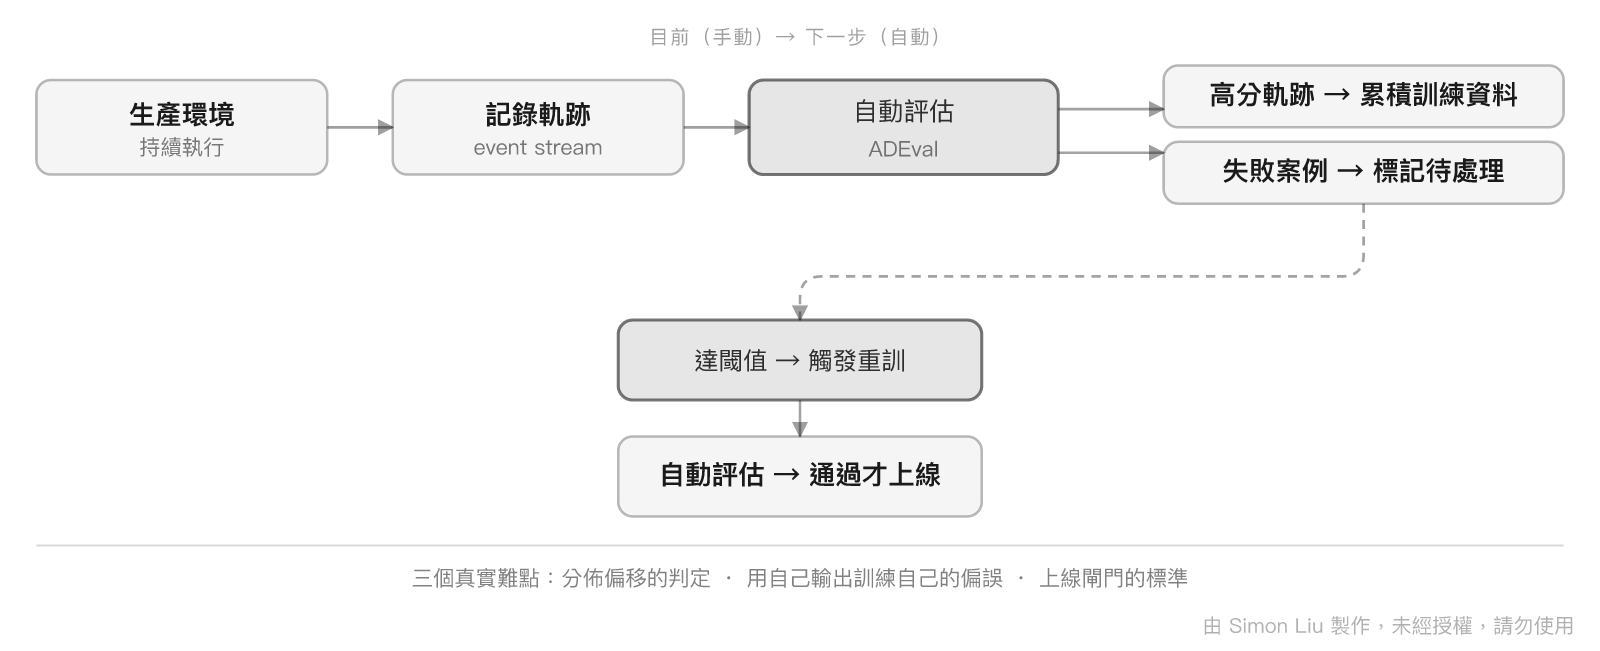
生產環境的 Agent 持續產生軌跡。這一段其實不需要新東西 —— Day 11 的 TrajectoryRecorderPlugin 直接就是採樣器。
但生產環境有兩件事跟開發環境不同。
第一,不能全採。 一天十萬次請求,全部記錄下來的儲存與處理成本都不划算。實務上的採樣策略:
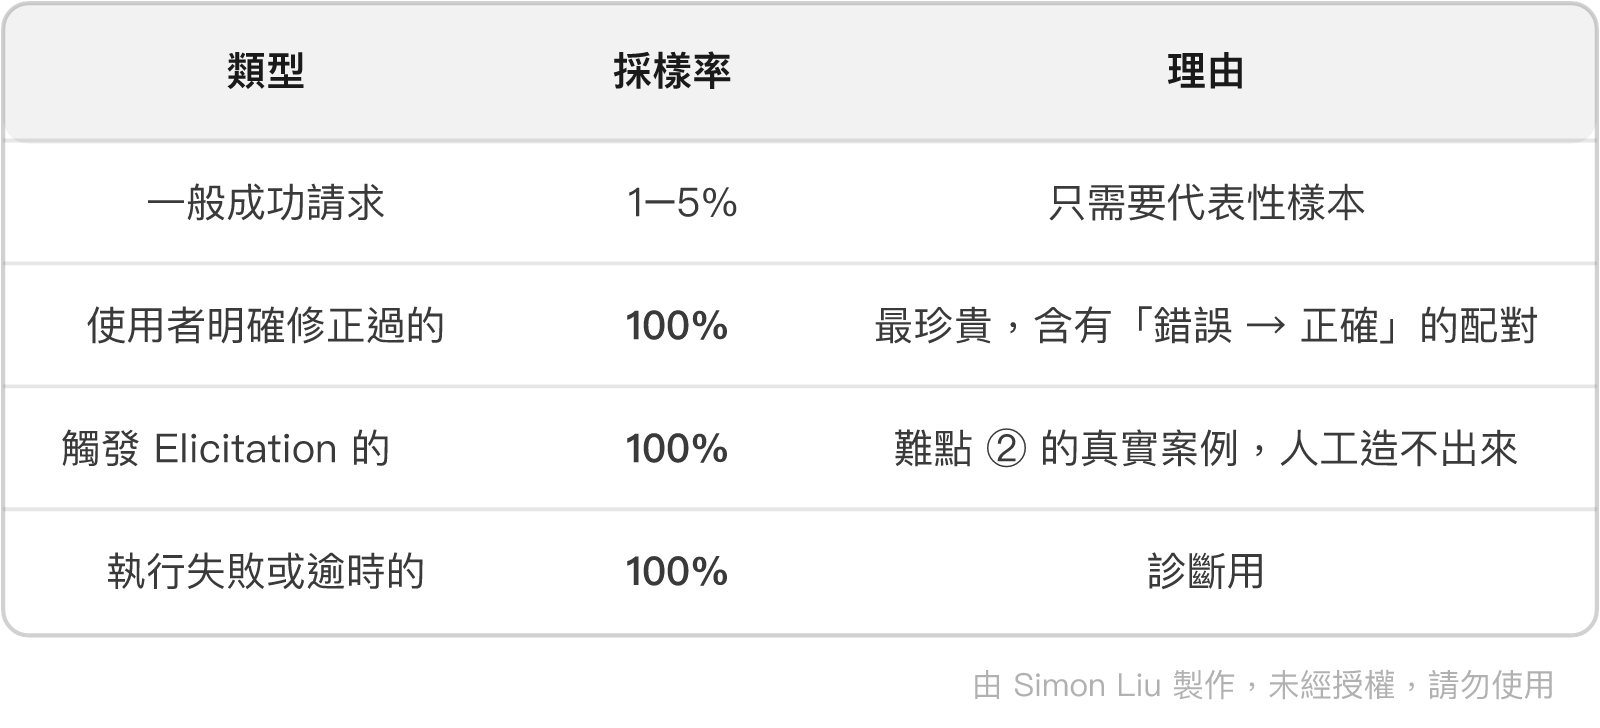
注意後三類都是全採。 這反映一個經驗:異常樣本的價值遠高於正常樣本,而它們的數量本來就少。
第二,脫敏必須是強制的,不是選配。 Day 11 的 scrub() 在開發環境是好習慣,在生產環境是合規要求。而且要記得 —— 生產資料裡的 PII 遠比開發環境多。
採樣進來的軌跡不能直接拿去訓練。這一步用的是 Day 12-14 建立的兩把尺,但用法不太一樣。
問題在於:生產軌跡沒有 expectedTools。
Day 13 的測試案例是我們寫的,所以知道正確答案。而生產環境的請求是使用者當下打的,沒有人事先寫好期望序列。
所以篩選只能靠不需要標準答案的訊號:
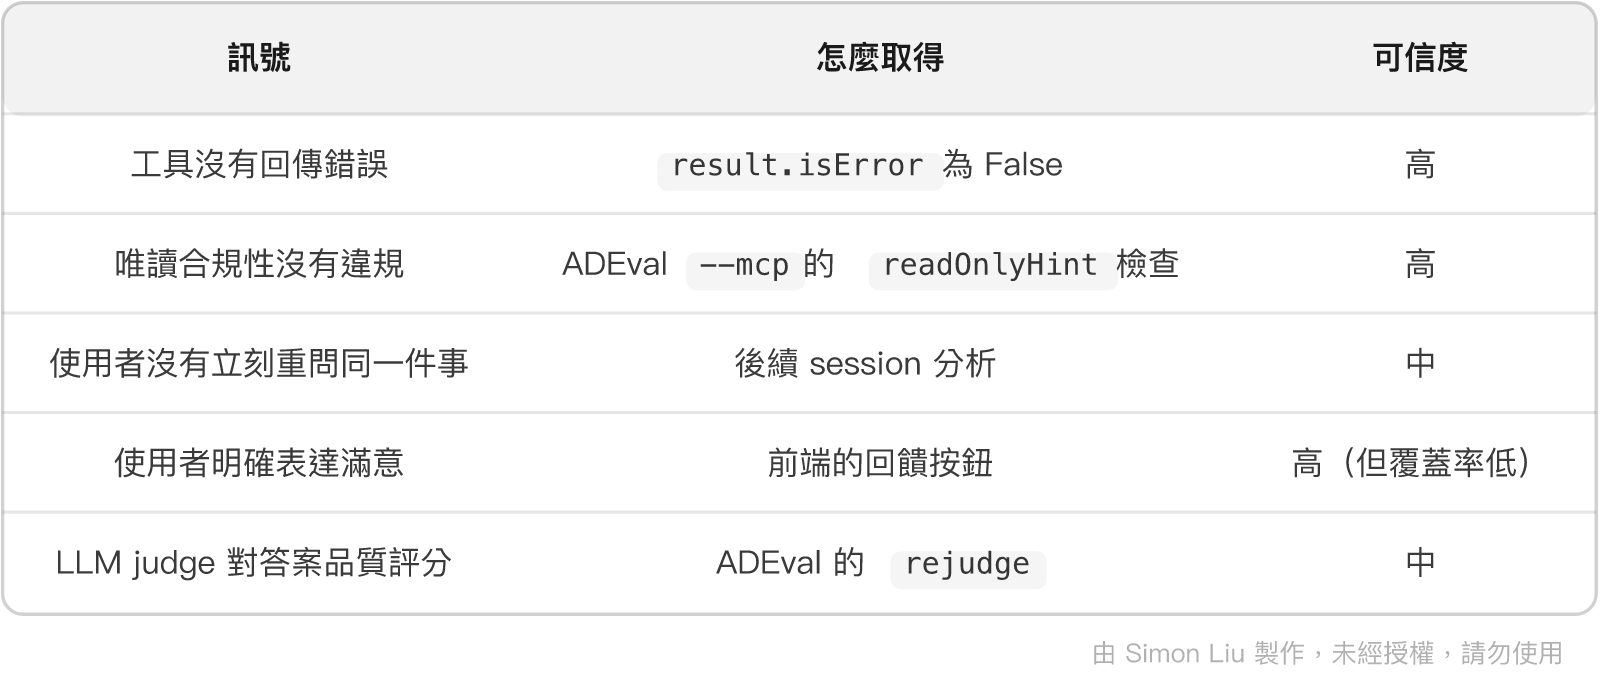
「高」的那幾項才適合當硬性篩選條件,「中」的只能當加權。
而其中最可靠的一個訊號,其實不在上表裡:難點 ① 的順序檢查。 Day 13 補上的 is_ordered_subset 不需要知道完整的期望序列 —— 只要檢查「有 update_leave_status 的話,前面有沒有 search_leaves」就成立。
這類「規則型的檢查」是生產軌跡篩選的主力,因為它們不需要標準答案。
累積到一定數量之後觸發訓練。這裡有三個決定要做。
第一,觸發條件。 建議用「新樣本數」而不是「時間」:
if 新增高品質樣本數 >= 500:
    觸發訓練
用時間觸發(例如每週一次)的問題是:某一週流量低,可能只累積了三十筆新樣本,訓練出來的差異在雜訊範圍內。
第二,是接著訓還是重訓?
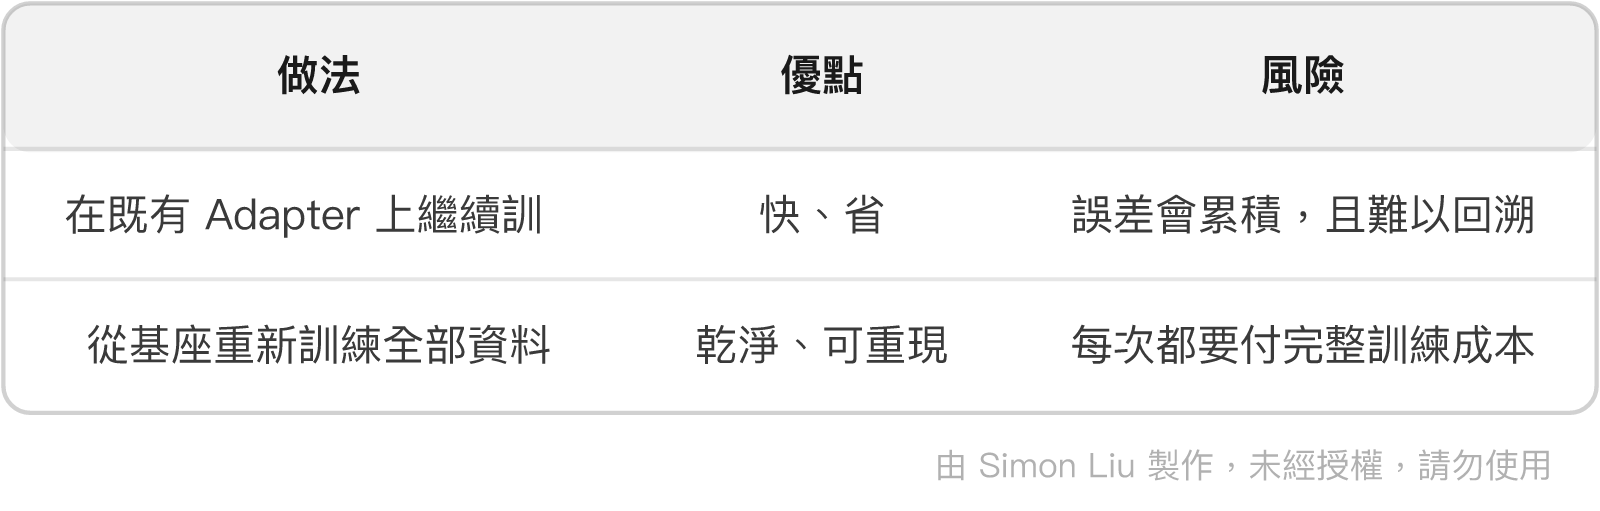
本系列建議後者。 LoRA 訓練 4B 模型只要一兩小時,而「可重現」的價值遠高於那點成本 —— 出問題時,您需要能夠回到任何一個歷史版本並重現它。
第三,舊資料要不要保留? 要,而且要保留全部。每次訓練用的是「全部歷史高品質樣本」,而不只是新增的那批。原因見下一節的模型崩潰。
實作上,Day 18 的 Colab CLI 讓這件事可以完全在 CI 裡跑:
colab run --gpu L4 --timeout 14400 train.py --dataset data/golden_v${VERSION}.jsonl
新版模型訓練完成,不能直接上線。
這一步是整條鏈路上最不能省的關卡,而且它的做法在 Day 23 已經演練過一次:
adeval benchmark exp_baseline \
  --app leave_copilot_current \
  --app leave_copilot_candidate \
  --mcp http://127.0.0.1:8090/mcp \
  --verify-args --judge
上線的條件必須事先寫死,而不是看到結果再決定:
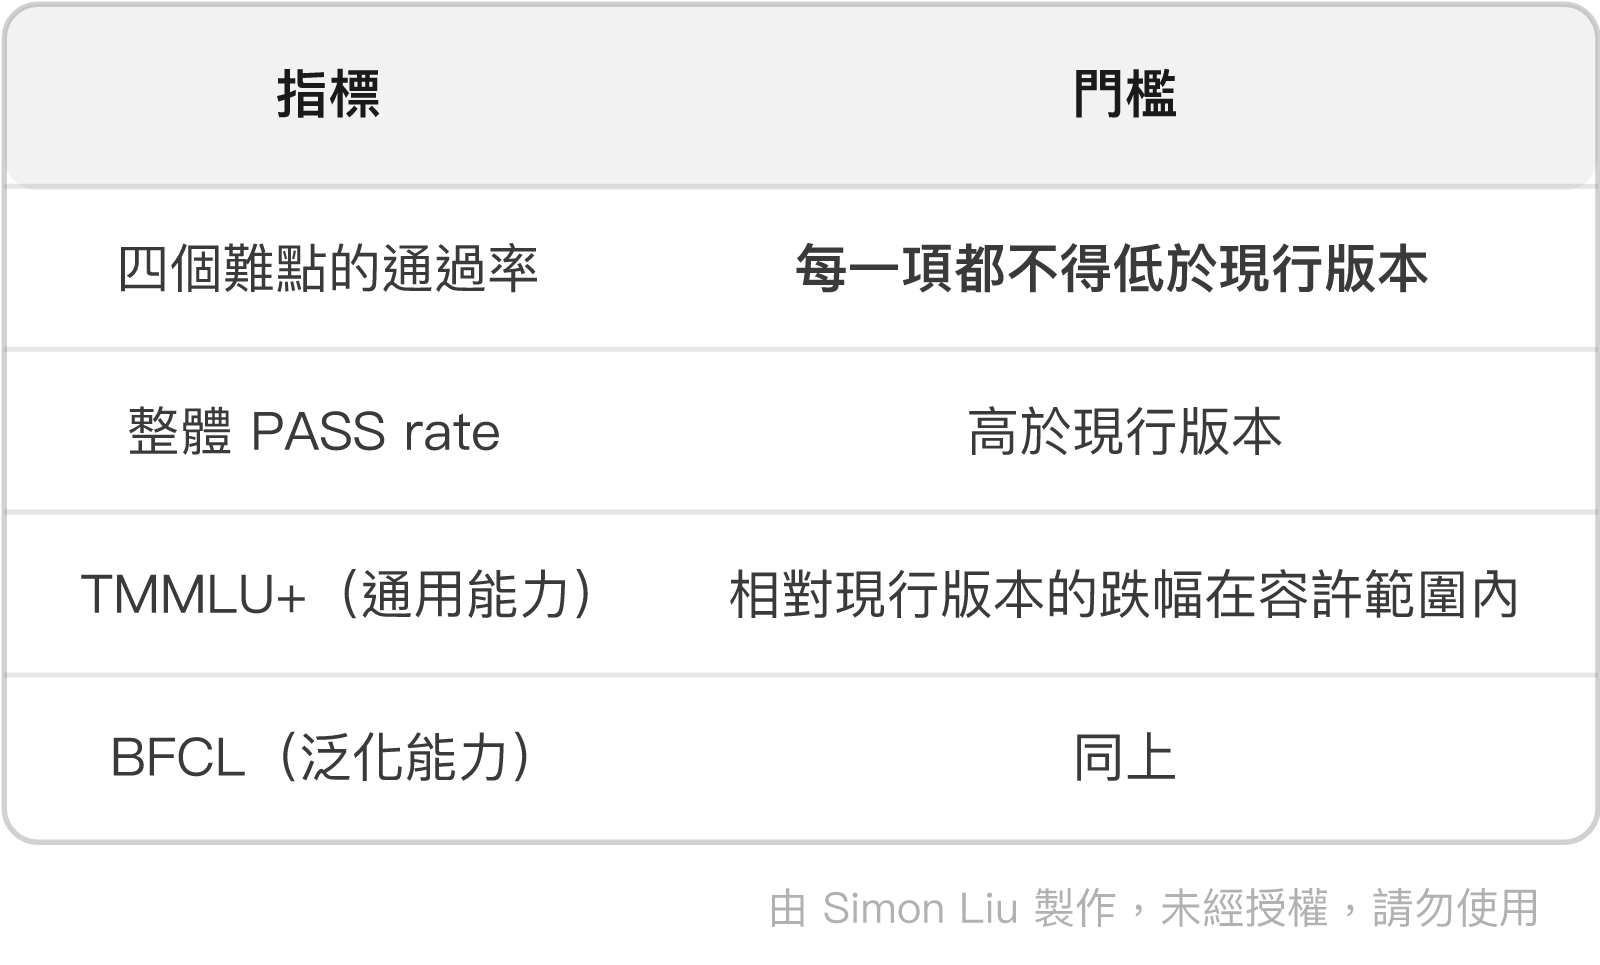
注意第一列的「每一項」。 整體分數上升但難點 ② 退步,代表模型在某個特定行為上退化了 —— 而那正是生產環境最危險的那一項。
沒有全部通過,就不上線。這條規則要在系統裡寫死,因為人在看到「整體提升了 3%」的時候,很容易說服自己那個退步的項目沒關係。
這裡有一個矛盾要處理。Day 13 說 Baseline 必須凍結,但業務會變 —— 新增了工具、改了狀態機,舊的測試案例就過時了。
解法是版本化,而不是就地修改:
baselines/
├── v1_2026-09.json      # 初版,九個工具
├── v2_2026-12.json      # 新增了三個員工工具
└── v3_2027-03.json      # 狀態機多了一個階段
同一個版本內部凍結,跨版本時明確標註「這裡換過尺」。 只要沒有偷偷改動,跨版本的數字就仍然是可解讀的。
自動化到這裡,看起來可以完全無人運轉了。但有三個位置必須留人。
第一,篩選標準的調整。 什麼樣的軌跡算「好」,這是一個會隨業務改變的判斷。自動化的是「套用標準」,不是「決定標準」。
第二,上線的最終核可。 即使所有指標都通過了,仍然建議保留一個人按下去的動作 —— 尤其是在模型會執行破壞性操作的場景。
第三,異常樣本的檢視。 系統只會篩掉不合格的軌跡,但**「為什麼會出現這批不合格的軌跡」是它答不出來的**。那可能是使用者的用法變了、可能是上游系統改了格式、也可能是有人在嘗試攻擊。
這三件事的共同特徵是:它們需要理解「為什麼」,而不只是「是什麼」。
最後要處理這條路上最容易出事的地方。
自我進化閉環有一個相當隱蔽的失敗模式:模型自己產生的資料,被拿去訓練它自己。
第 1 版模型 → 產生軌跡 → 篩選 → 訓練 → 第 2 版模型
第 2 版模型 → 產生軌跡 → 篩選 → 訓練 → 第 3 版模型
   ⋯
每一輪,模型都在學習自己的輸出。而篩選只留下「成功的」軌跡 —— 這聽起來很合理,但它會造成一個後果:
模型會越來越只做它已經擅長的事。
那些它做得不夠好、因此被篩掉的行為,永遠不會出現在訓練資料裡。多樣性單調遞減,這就是模型崩潰(Model Collapse)。
症狀是:自訂任務的分數持續上升,但模型面對稍微不同的問法就完全不會了 —— 它變得非常擅長一組越來越窄的情況。
第一,保留原始的黃金資料。 每一輪訓練都混入 Day 15-16 那批人工設計與驗證過的樣本,維持一個不會漂移的錨點。
第二,優先採用「有人類介入」的軌跡。 使用者修正過的、拒絕過的、明確評分過的 —— 這些軌跡裡有外部訊號,不是模型自己的輸出。
這是最有效的一項。 也是為什麼採樣策略要把這幾類設成 100%。
第三,用 Twinkle Eval 當早期警報。 TMMLU+ 的分數是外部基準,模型崩潰會先反映在它身上,而且通常早於自訂任務的分數下滑。
Day 14 建立的那條通用能力基準線,在這裡才顯出它真正的價值 —— 它不只是微調前後的一次性對照,而是長期監控的儀表板。
第四,定期注入新的人工案例。 不能只靠生產流量。每隔一段時間手寫一批新的難題,特別是針對模型現在不擅長的方向。
自我進化閉環不是「讓模型自己變強」,而是「讓人的判斷能夠更有效率地被放大」。
如果把人完全拿掉,這個閉環會朝著自我強化的方向收斂 —— 而那個方向不一定是您想要的方向。
把手動的鏈路自動化,本質上是把「工程師的時間」從搬運工作中釋放出來,投入到判斷工作上。
總結來說,今天有三個重點值得帶走:
update_leave_status 就必須先有 search_leaves」不需要知道完整的期望序列。而使用者修正過、拒絕過、失敗過的軌跡要全採,因為異常樣本的價值遠高於正常樣本。明天是最後一天,要回頭盤點這 30 天的完整成果,也誠實談談哪些地方做得不夠好、以及如果重來一次會怎麼調整。
google/adk/plugins/base_plugin.py(google-adk 2.7.1)——on_event_callback 作為採樣掛載點benchmark、rejudge、rescore
repeat_runs
colab run 用於 CI 觸發一次性訓練任務查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術